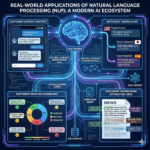
Após compreendermos a evolução histórica e as técnicas de tokenização, o ciclo de Processamento de Linguagem Natural converge para a execução de tarefas. Na Ciência de Dados, aplicações de PLN são projetadas para tarefas delimitadas, como classificação, extração, recuperação e geração, utilizando diferentes métodos computacionais [4].
Abaixo, organizamos as aplicações contemporâneas do PLN pelas tarefas concretas que as sustentam, juntamente com os métodos de avaliação e os riscos inerentes à sua operação.
1. Classificação de Textos e Análise de Sentimentos
A classificação atribui rótulos discretos a sequências de texto, sendo aplicada na categorização de documentos, roteamento de incidentes ou detecção de padrões de toxicidade.
Uma vertente analítica específica é a Análise de Sentimento, dedicada à identificação computacional de opiniões ou estimativa de polaridade (positiva, negativa, neutra) em acervos documentais [1]. Essa tarefa difere estruturalmente da classificação de emoções, que exige ontologias psicológicas dedicadas.
2. Extração de Entidades Nomeadas (NER)
A tarefa de Extração de Entidades Nomeadas (NER) localiza e classifica referências específicas no texto em categorias pré-definidas (como Organizações, Pessoas e Locais) [2]. Identificadores pessoais, como CPF e e-mail, podem exigir regras estruturadas, detectores especializados ou abordagens híbridas, conforme a política de proteção de dados aplicável.
3. Recuperação de Informação e RAG
A Recuperação de Informação por vetores densos permite localizar documentos avaliando a similaridade entre representações aprendidas, em vez de depender exclusivamente de buscas léxicas exatas.
Essa abordagem viabilizou a arquitetura RAG (Retrieval-Augmented Generation). RAG acrescenta evidências recuperadas ao contexto do gerador. A qualidade final depende do corpus, da recuperação, da atribuição das fontes e da validação da resposta [3].
4. Tradução Automática e Sumarização
A tradução automática baseia-se em arquiteturas neurais que mapeiam representações entre diferentes idiomas. Por sua vez, a Sumarização atua condensando textos longos. Ela pode ser extrativa (selecionando frases representativas de origem) ou abstrativa (gerando frases sintetizadas condicionadas ao texto de origem) [4].
5. Geração de Texto e Acessibilidade
Aplicações interativas operam com modelos autorregressivos (como a família GPT). Esses modelos estimam iterativamente a probabilidade do próximo token, compondo sequências [4].
Em Comunicação Aumentativa e Alternativa (CAA), modelos de linguagem podem apoiar recursos de predição e composição textual. Sua utilidade precisa ser avaliada com usuários, profissionais e critérios de acessibilidade, segurança e adequação ao contexto.
6. Avaliação, Supervisão Humana e Riscos
Modelos de linguagem podem reproduzir ou amplificar associações e vieses relacionados aos dados, às escolhas de desenvolvimento e ao contexto de utilização. Seu desempenho na produção de sequências não autoriza atribuir-lhes intenção ou compreensão humana [5]. Respostas plausíveis sem sustentação nas evidências disponíveis constituem outro risco e devem ser verificadas antes de orientar decisões.
Métricas como BLEU, ROUGE e F1-score podem integrar, respectivamente, avaliações de tradução, sumarização e classificação ou extração [4]. Sua adequação depende da tarefa, dos dados e dos tipos de erro relevantes. Quando necessário, devem ser complementadas por análise qualitativa, avaliação humana e indicadores do domínio. A validação cruzada também não é universalmente apropriada: dados temporais, agrupados ou dependentes podem exigir outras estratégias de particionamento.
7. O Papel do DSE Support NLP
Na série até agora, acompanhamos os requisitos básicos de preparação. No LAB-01 do DSE Support NLP, validamos a infraestrutura inicial: o carregamento offline, o comportamento fail-closed, a preparação textual, a normalização Unicode, a tokenização e a representação didática (incluindo uma demonstração prática de leakage). É imperativo declarar que tarefas finais como classificação, RAG, geração ou desempenho operacional ainda não foram validadas pelo laboratório.
Fique conosco para o Episódio 5: O Futuro do Processamento de Linguagem Natural!
Referências
- [1] Pang, B.; Lee, L. (2008). Opinion Mining and Sentiment Analysis. Foundations and Trends in Information Retrieval, 2(1-2), 1-135.
- [2] Nadeau, D.; Sekine, S. (2007). A survey of named entity recognition and classification. Lingvisticae Investigationes, 30(1), 3-26.
- [3] Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems (NeurIPS).
- [4] Jurafsky, D.; Martin, J. H. (2026). Speech and Language Processing. 3rd ed. Online manuscript released August 19, 2026.
- [5] Bender, E. M. et al. (2021). On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?. Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency (FAccT).