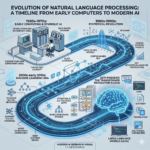
A trajetória do Processamento de Linguagem Natural (PLN) frequentemente é contada como uma sucessão simples de revoluções tecnológicas. No entanto, o desenvolvimento da área foi cumulativo: diferentes abordagens foram reformuladas, algumas perderam protagonismo e outras continuam sendo empregadas ou combinadas em tarefas específicas.
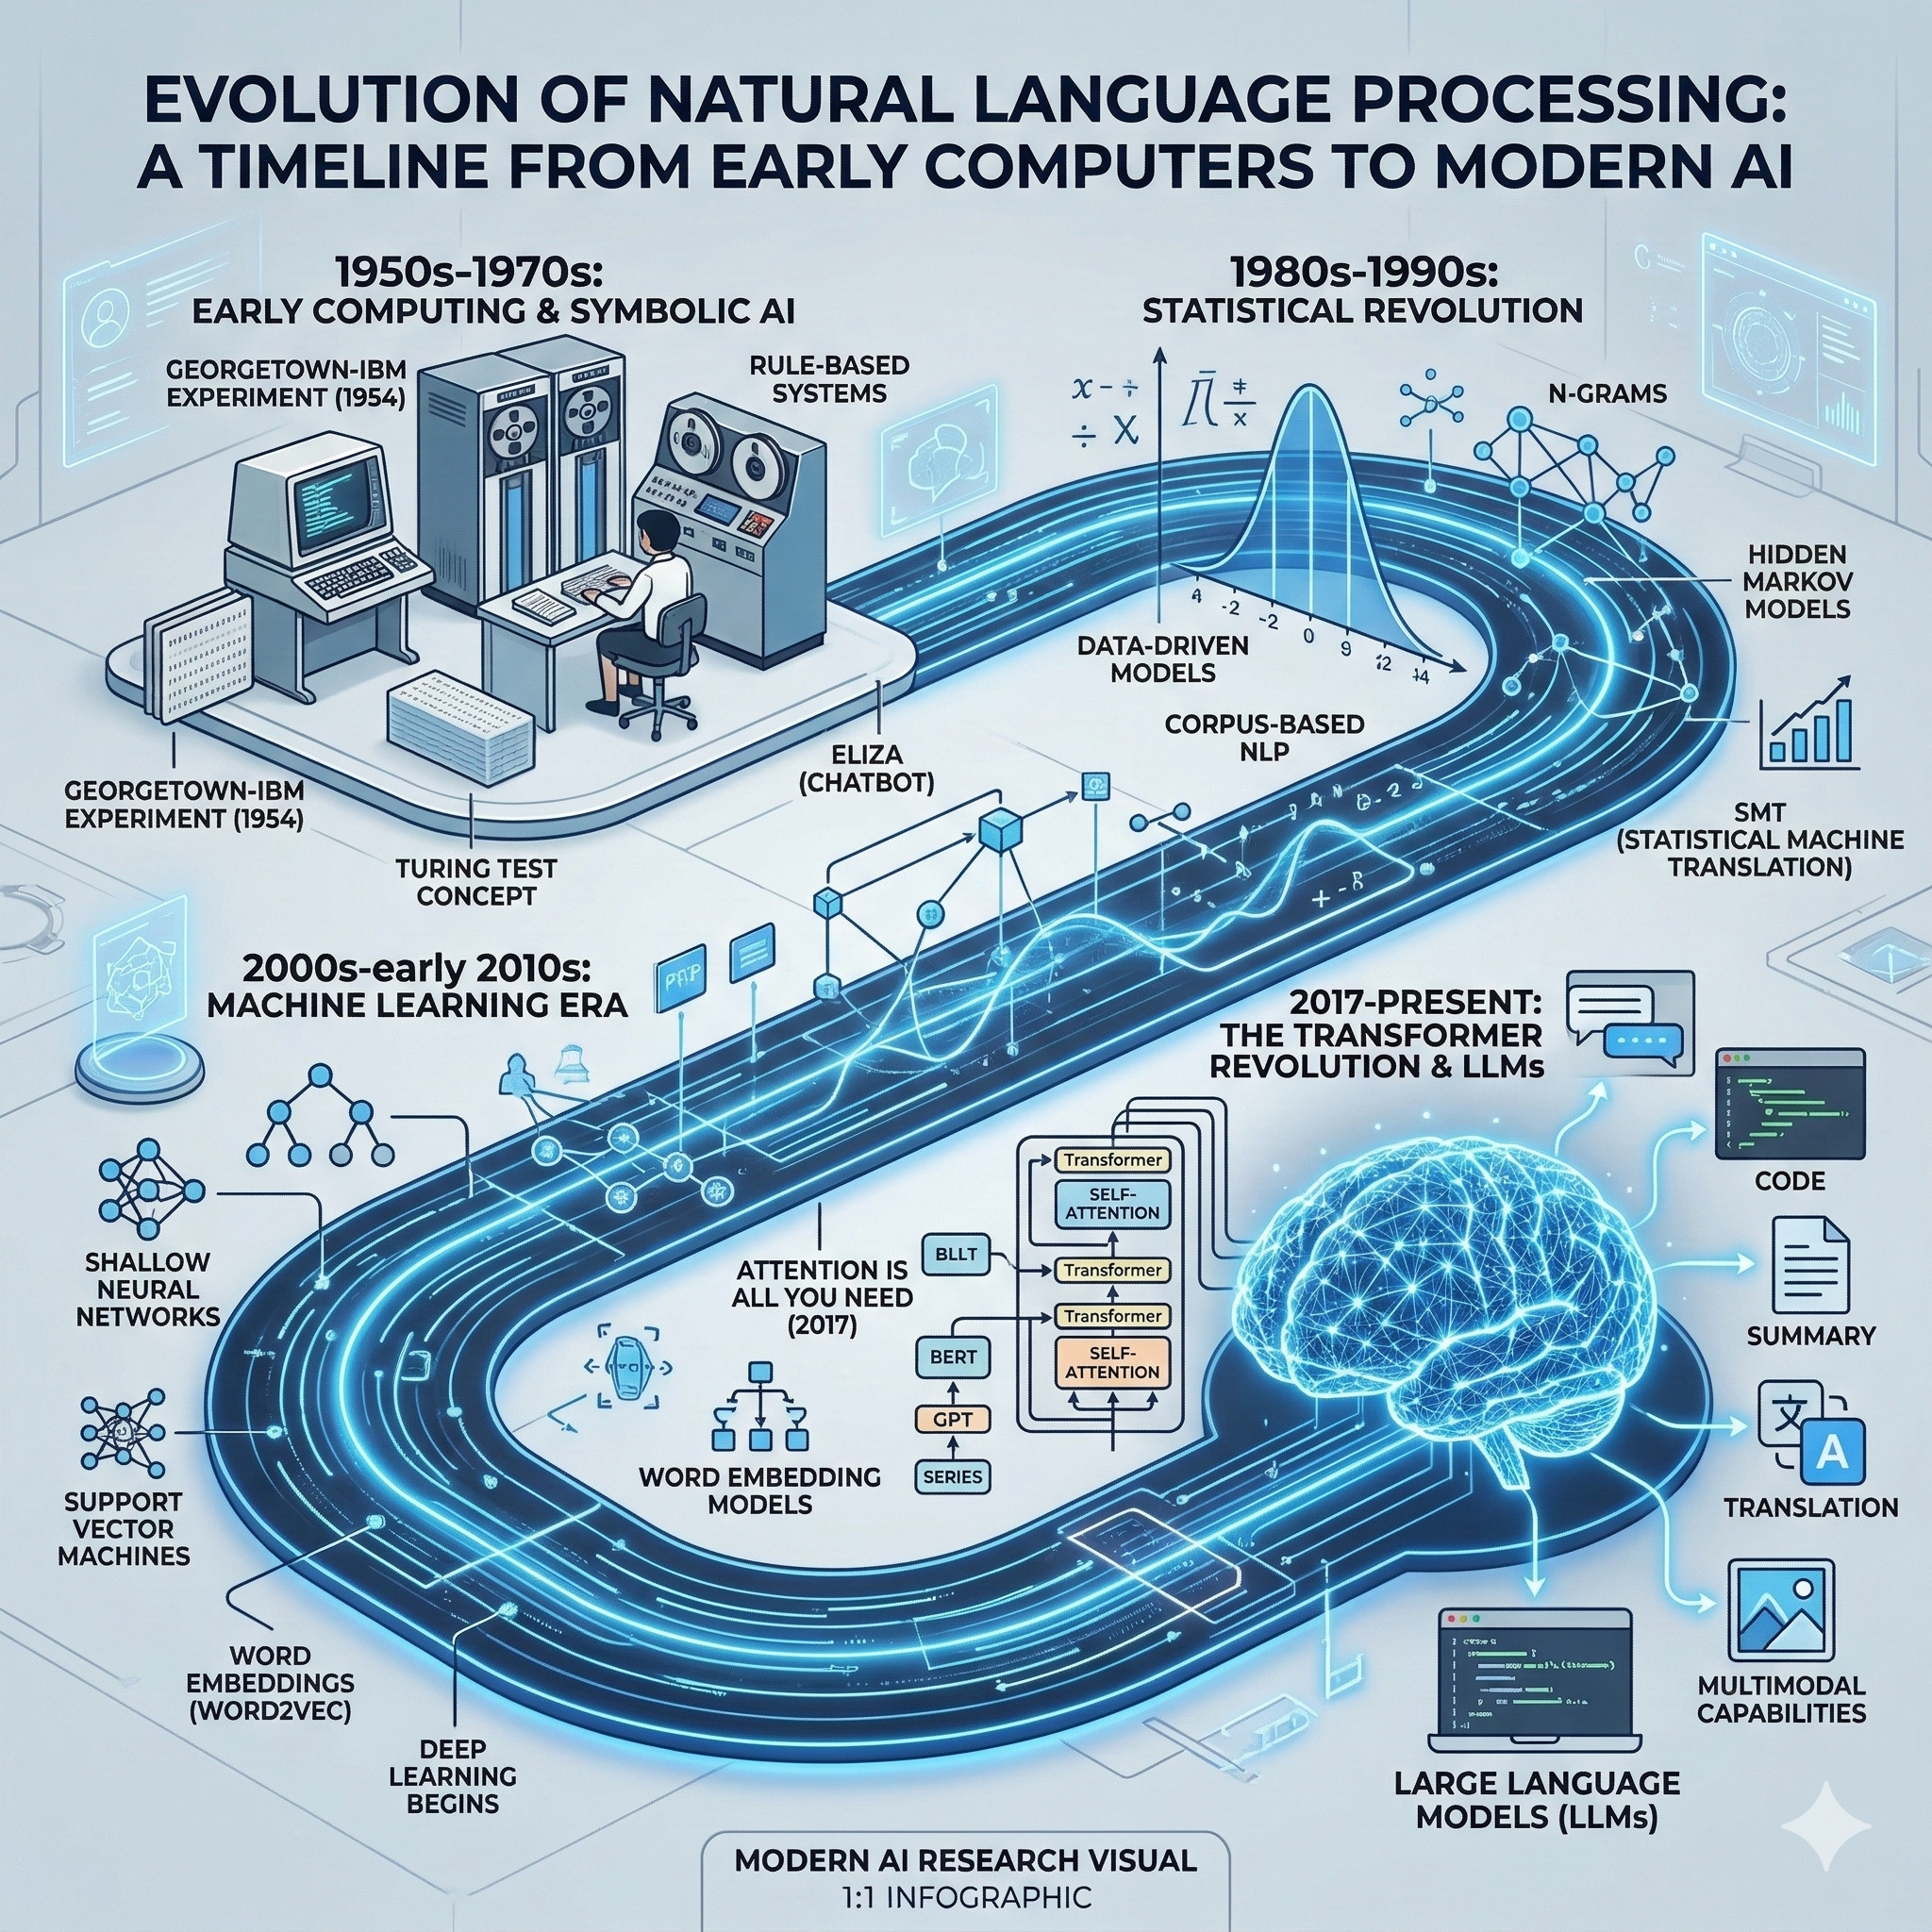
Neste segundo episódio da nossa série, exploraremos os marcos fundamentais que moldaram o PLN, desde os primeiros experimentos pós-Segunda Guerra Mundial até os modelos de atenção que formam a base dos sistemas atuais.
As origens fundacionais: criptografia, tradução e comportamento
Logo após a Segunda Guerra Mundial, o sucesso na quebra de códigos criptográficos inspirou a percepção de que a linguagem humana poderia, de alguma forma, ser analisada como um código estruturado. Em 1949, Warren Weaver redigiu um memorando sugerindo que as técnicas estatísticas e criptográficas da guerra fossem aplicadas para a Tradução Automática entre idiomas. O memorando tornou-se uma referência histórica importante para a tradução automática, ao relacionar tradução, criptografia, teoria da informação e métodos estatísticos [1].
No ano seguinte, em 1950, o matemático Alan Turing publicou o seminal artigo Computing Machinery and Intelligence. Turing deslocou a discussão abstrata sobre se máquinas “pensam” para um critério operacional baseado no desempenho observado durante uma interação textual [2]. Embora tratassem de problemas distintos, os dois trabalhos passaram a integrar a história intelectual e técnica do processamento computacional da linguagem.
A era simbólica e os limites do diálogo
Nas décadas de 1960 e 1970, pesquisadores investiram em sistemas baseados em regras e conhecimento codificado manualmente. A premissa era estruturar gramáticas formais e dicionários lógicos.
O exemplo mais célebre dessa fase é o programa ELIZA (1966), criado por Joseph Weizenbaum [3]. Uma de suas configurações mais conhecidas, o script DOCTOR, imitava certos padrões de uma entrevista psicoterapêutica por meio de palavras-chave e regras de decomposição e recomposição. As interações com ELIZA mostraram que usuários podiam atribuir ao programa capacidades que excediam seu mecanismo de funcionamento baseado em padrões. ELIZA permite observar os limites de sistemas de diálogo fortemente dependentes de padrões e respostas previamente estruturadas. Isso não representa, isoladamente, todas as abordagens simbólicas de PLN.
A expansão probabilística e o aprendizado estatístico
Entre as décadas de 1980 e 1990, métodos probabilísticos ganharam espaço em diferentes tarefas de PLN, favorecidos pela disponibilidade de corpora, recursos computacionais e técnicas de estimação estatística. Em vez de determinar rigidamente se uma frase gramatical estava “correta”, algoritmos passaram a estimar, através de grandes volumes de dados textuais, a probabilidade de ocorrência conjunta de sequências de palavras. Modelos Ocultos de Markov (HMMs) e modelos de linguagem baseados em N-gramas impulsionaram consideravelmente o reconhecimento de fala e a tradução automática estatística [8].
Modelos neurais e representações distribuídas
Um passo conceitual fundamental ocorreu quando Bengio e colaboradores apresentaram, em 2003, um modelo neural probabilístico de linguagem que aprendia conjuntamente uma representação distribuída das palavras e uma função de probabilidade para sequências [4].
Avançando nessa direção, em 2013, os trabalhos de Mikolov e colaboradores apresentaram arquiteturas eficientes, como CBOW e Skip-gram, para aprender representações distribuídas em grandes corpora [5]. As relações observadas nesses espaços vetoriais refletem regularidades dos dados de treinamento, sem equivaler a uma representação completa do significado.
Mecanismos de atenção e os Transformers
Apesar do sucesso das arquiteturas sequenciais, a necessidade de capturar dependências contextuais muito longas ainda era um gargalo.
Em 2017, Attention Is All You Need propôs a arquitetura Transformer, organizada em torno de mecanismos de atenção e sem recorrência ou convolução no núcleo da arquitetura. A autoatenção permite relacionar diferentes posições da sequência, enquanto informações posicionais preservam a ordem dos tokens [6].
Essa arquitetura sustentou modelos posteriores como o BERT (2019), projetado para pré-treinar representações profundamente bidirecionais e adaptá-las a diferentes tarefas [7]. Transformers também passaram a compor modelos autorregressivos, nos quais a geração continua ocorrendo token a token.
A coexistência metodológica contemporânea
Ao contrário do que as narrativas de “revoluções” sugerem, as novas técnicas não extinguiram as antigas. No desenvolvimento de software contemporâneo, abordagens simbólicas (expressões regulares para anonimização), probabilísticas (modelos de classificação tradicionais para ambientes com poucos recursos) e neurais (modelos grandes baseados em Transformers) coexistem dentro da mesma aplicação [8]. Projetar sistemas de PLN exige avaliar restrições de latência, capacidade computacional e interpretabilidade para escolher as melhores ferramentas, não apenas as mais recentes.
Se você busca compreender os fundamentos técnicos da evolução destas aplicações analíticas na Ciência de Dados, nossa série de artigos é o ponto de partida. Além disso, o e-book Processamento de Linguagem Natural: dos fundamentos à implantação, integrante da coleção DSE, está em fase de revisão técnica e editorial. O livro apresentará os fundamentos, a infraestrutura e as decisões de engenharia associadas a essas arquiteturas.
Continue conosco no Episódio 3: Pipeline de Processamento de Texto em NLP!
Referências
- [1] Weaver, W. (1949). Translation. Memorandum of July 15, 1949. Republished in Locke, W. N.; Booth, A. D. (Eds.), Machine Translation of Languages, MIT Press, 1955.
- [2] Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433-460.
- [3] Weizenbaum, J. (1966). ELIZA—a computer program for the study of natural language communication between man and machine. Communications of the ACM, 9(1), 36-45.
- [4] Bengio, Y. et al. (2003). A Neural Probabilistic Language Model. Journal of Machine Learning Research, 3, 1137-1155.
- [5] Mikolov, T. et al. (2013). Efficient Estimation of Word Representations in Vector Space (arXiv:1301.3781); e Distributed Representations of Words and Phrases and their Compositionality (NeurIPS).
- [6] Vaswani, A. et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS).
- [7] Devlin, J. et al. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL-HLT.
- [8] Jurafsky, D.; Martin, J. H. (2026). Speech and Language Processing. 3rd ed. Online manuscript released August 19, 2026.