
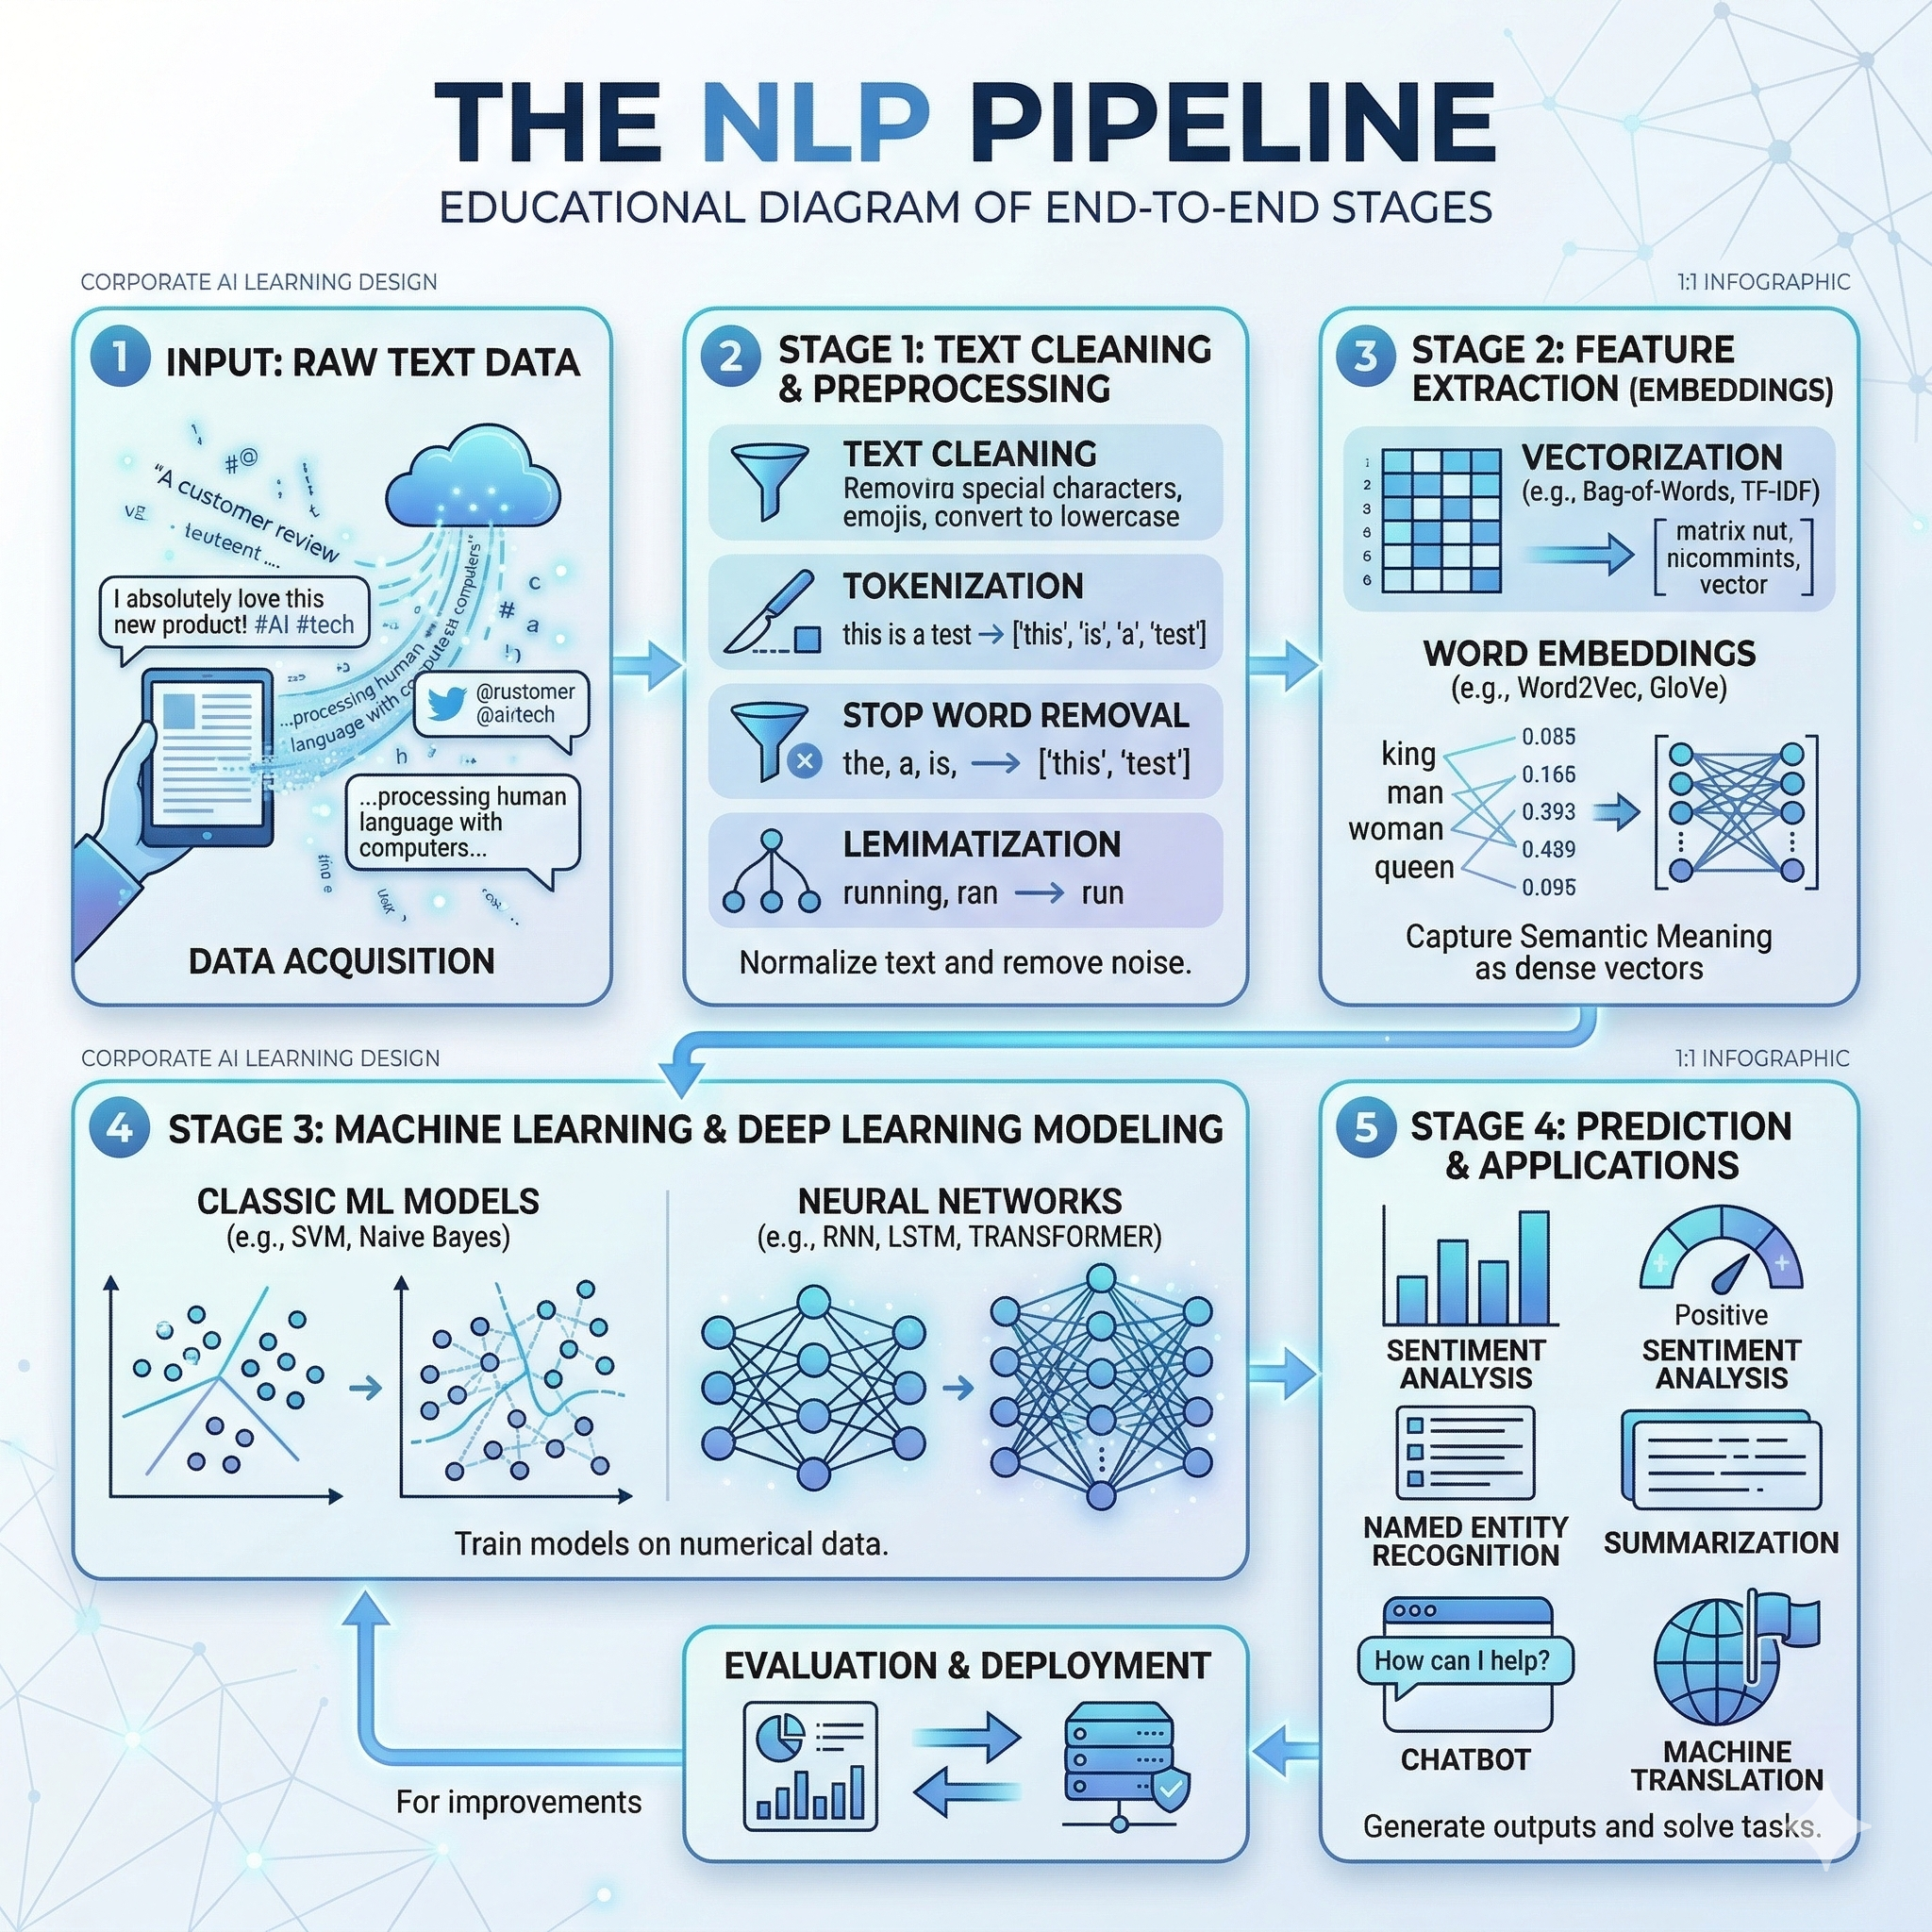
No desenvolvimento de aplicações analíticas e na manipulação de linguagem, é tentador focar exclusivamente no treinamento dos algoritmos. Contudo, entre o recebimento do dado bruto e a geração de inferências precisas, reside uma camada decisiva: a preparação do texto. Na prática de Engenharia de Machine Learning, a forma como codificamos a linguagem define — e muitas vezes limita — o potencial do modelo.
Abaixo, detalhamos as decisões arquitetônicas, as técnicas contemporâneas de tokenização e os riscos embutidos nas rotinas de processamento de texto em Processamento de Linguagem Natural (PLN).
1. O mito da “limpeza universal” e as quatro operações
Um erro histórico comum na Ciência de Dados é a crença na existência de um pipeline de “limpeza de dados padrão” que envolva a remoção de pontuações, stopwords (termos frequentes como preposições) e formatações. Na realidade, a preparação do texto não é universal: ela depende criticamente do domínio do problema, da arquitetura do modelo adotado e das regras definidas no tokenizador.
O LAB-01 demonstra, em exemplos controlados e sob configurações documentadas, possíveis efeitos dessas decisões (ex: remoção de stopwords antes de um modelo probabilístico moderno pode anular marcadores cruciais de negação).
A preparação deve ser entendida através de quatro decisões lógicas:
- Preservação: manter sinais de pontuação vitais para delimitar sentenças gramaticais ou entonação, especialmente em modelos de contexto longo.
- Transformação: converter o texto para representações uniformes e previsíveis.
- Mascaramento: substituir dados pessoais ou identificadores por marcadores definidos em uma política documentada. A estratégia deve considerar finalidade, reversibilidade, risco de colisão e validação humana de segurança e LGPD (como <CPF_MASCARADO>).
- Exclusão: remover apenas resíduos irrecuperáveis ou caracteres de controle estritos (como a representação U+0000 do byte nulo) que impactem o pipeline.
2. A importância e os limites da Normalização Unicode
A linguagem na internet exibe enorme variação tipográfica. Letras acentuadas podem ser formadas de maneiras estruturalmente distintas: um caractere composto ou a combinação da letra base com um acento diacrítico.
A forma de normalização deve ser escolhida e documentada conforme o domínio, o tokenizador e o modelo. NFC e NFD tratam equivalências canônicas; NFKC e NFKD também aplicam equivalências de compatibilidade e podem eliminar distinções relevantes [1]. Aplicar NFKC indistintamente sob a falsa premissa de “limpeza” pode condensar informações numéricas cruciais (como subscritos de fórmulas químicas) resultando na perda de sinal semântico.
3. Tokenização, Vocabulários e IDs
Sistemas de software podem manipular strings diretamente, mas modelos neurais normalmente recebem representações numéricas. A tokenização segmenta o texto em unidades que posteriormente são associadas a identificadores inteiros. Em vocabulários estritamente baseados em palavras, entradas ausentes podem ser representadas por um token desconhecido (OOV – Out of Vocabulary) ou exigir uma estratégia alternativa de segmentação.
4. BPE, WordPiece e SentencePiece
Para mitigar as limitações de cobertura puramente baseadas em palavras, métodos modernos operam no nível de subpalavras, o que ajuda a representar termos raros ou desconhecidos, mas não elimina universalmente todos os problemas de cobertura [2].
- BPE (Byte-Pair Encoding): Mescla iterativamente os pares de símbolos mais frequentes. Pode garantir a reconstrução de qualquer entrada quando a implementação parte de um alfabeto que ofereça essa cobertura total, como na tokenização byte-level.
- WordPiece: constrói um vocabulário de subpalavras mediante um critério de seleção associado à verossimilhança dos dados de treinamento [3].
- SentencePiece: É um framework flexível que suporta métodos como BPE e Unigram, operando diretamente a partir do texto bruto sem depender de segmentação ou espaços pré-computados, representando o espaço internamente como o caractere especial ▁ (U+2581 LOWER ONE EIGHTH BLOCK) [4].
Os tokens são associados a IDs inteiros do vocabulário. Esses IDs funcionam como índices para consultar as linhas correspondentes da matriz de embeddings.
5. Os riscos do tratamento imprudente: Vazamento, Atalhos e Perda de Sinal
Decisões equivocadas nas etapas iniciais podem comprometer a validade dos experimentos e a capacidade de generalização:
- Perda de informação: A padronização severa pode eliminar marcadores semânticos cruciais, resultando, por exemplo, na perda do sinal de negação estrutural.
- Atalhos espúrios: características que permitem predizer o rótulo sem representar adequadamente o fenômeno de interesse, podendo comprometer a generalização quando sua associação muda ou desaparece.
- Leakage (Vazamento de Dados): Ocorre de forma distinta, quando informações da validação, do teste, do futuro ou derivadas do alvo influenciam o ajuste das transformações, do vocabulário, do modelo ou das decisões experimentais. A orientação oficial é dividir os dados rigorosamente antes de ajustar qualquer transformação aprendida [5].
Essas premissas são essenciais para reduzir o risco de avaliações contaminadas, perda de informação e dependência de sinais que não se mantêm no ambiente de uso. Esses conceitos são discutidos na literatura de PLN [6]. No LAB-01 do DSE Support NLP, alguns de seus efeitos foram demonstrados em exemplos controlados e sob configurações documentadas.
Continue a série no Episódio 4: Aplicações do PLN e Automação!
Referências
- [1] Whistler, K. (2025). Unicode Standard Annex #15: Unicode Normalization Forms. Revision 57, Unicode 17.0.0. Unicode Consortium. Data de consulta: 6 set. 2026.
- [2] Sennrich, R.; Haddow, B.; Birch, A. (2016). Neural Machine Translation of Rare Words with Subword Units. ACL.
- [3] Schuster, M.; Nakajima, K. (2012). Japanese and Korean Voice Search. ICASSP.
- [4] Kudo, T.; Richardson, J. (2018). SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing. EMNLP.
- [5] Scikit-learn Developers. Common pitfalls and recommended practices (Data leakage). Documentation.
- [6] Jurafsky, D.; Martin, J. H. (2026). Speech and Language Processing. 3rd ed. Online manuscript released August 19, 2026.
Uma resposta para “Semana 3 — Preparação e representação de textos: decisões, tokenização e riscos (Série PLN — Ep.3)”
[…] Continue conosco no Episódio 3: Pipeline de Processamento de Texto em NLP! […]