Você já parou para pensar em como um sistema automático classifica uma avaliação de produto, localiza informações em documentos ou produz uma tradução para outro idioma?
Por trás dessas aplicações está o Processamento de Linguagem Natural (PLN) — ou Natural Language Processing (NLP), em inglês.
O PLN é uma área profundamente interdisciplinar, situada na intersecção da Ciência da Computação, Inteligência Artificial e Linguística Computacional. O PLN reúne métodos computacionais baseados em regras, modelos estatísticos e arquiteturas neurais para representar e processar textos ou fala. Esses sistemas identificam regularidades nos dados e executam tarefas linguísticas delimitadas, sem que isso autorize atribuir a eles compreensão humana, intenção ou consciência [1].
Como o computador processa a linguagem humana?
Projetar sistemas computacionais para operar sobre a linguagem natural apresenta desafios técnicos significativos. Diferentemente das linguagens de programação, que possuem sintaxe formalmente definida, a linguagem humana admite ambiguidades, variações e dependências contextuais. Os pesquisadores e engenheiros da área precisam lidar com [1]:
- Ambiguidade: Uma mesma forma textual pode admitir interpretações diferentes conforme o contexto.
- Contexto e ordem: relações entre palavras e trechos podem mudar conforme sua posição e o contexto em que aparecem.
- Variação vocabular: Gírias, jargões, ironias e construções não padronizadas.
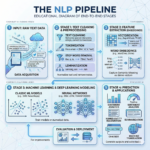
Para representar parte desses fenômenos, muitos sistemas contemporâneos segmentam o texto em tokens, associando-os a identificadores numéricos e convertendo-os em representações vetoriais. Essas representações podem codificar regularidades de uso observadas nos dados de treinamento e servir como entrada para tarefas como classificação, recuperação de informação e geração de texto. O procedimento depende do tokenizador, do modelo e do domínio de aplicação [1].
Principais aplicações do PLN
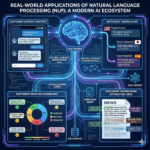
As técnicas de PLN são a base para diversas soluções integradas em produtos digitais de uso massivo:
- Tradução Automática: Arquiteturas neurais avaliam o texto de origem e produzem a sequência correspondente mais provável no idioma de destino.
- Modelos de Linguagem e Chatbots: Muitos chatbots atuais utilizam modelos de linguagem autorregressivos, que estimam probabilidades sobre possíveis tokens seguintes condicionados ao contexto disponível.
- Análise de Sentimento: Modelos de classificação podem atribuir a textos rótulos ou escores relacionados a categorias como sentimento positivo, negativo ou neutro, conforme a taxonomia e os dados utilizados.
- Extração de Informação: Sistemas de extração de informação podem identificar entidades, relações e outros elementos definidos pela tarefa, auxiliando a organização e a análise de documentos.
O papel do PLN na Ciência de Dados
Organizações produzem grandes volumes de dados textuais, como documentos, avaliações, e-mails, laudos e artigos científicos.
Na Ciência de Dados, técnicas de PLN permitem representar parte desse conteúdo textual em estruturas numéricas adequadas a tarefas analíticas. Isso enriquece os pipelines analíticos, complementa análises baseadas em dados tabulares e amplia as fontes de informação disponíveis. Em contextos organizacionais, técnicas de PLN podem apoiar a indexação de documentos, a classificação de solicitações, a recuperação de informações e a análise de relatórios. Aplicações em saúde, finanças ou outros domínios regulados exigem validação específica, controles de segurança e supervisão humana.
Indo além: a infraestrutura por trás do texto
A teoria por trás dessas transformações vetoriais exige escolhas técnicas rigorosas. A escolha do tokenizador pode alterar a representação das entradas e influenciar o comportamento do pipeline.
Neste primeiro episódio, abordamos a fundamentação sobre a utilidade do PLN. Nos próximos episódios da nossa Série PLN, vamos aprofundar na história, no pipeline de processamento e, gradativamente, migrar para a infraestrutura.
Esta série também dialoga com o e-book Processamento de Linguagem Natural: dos fundamentos à implantação, integrante da coleção DSE — Da Infraestrutura à Inteligência Aplicada. O volume está em desenvolvimento e passará por revisão técnica, científica, editorial e de segurança antes de sua publicação.
Fique ligado para o Episódio 2: A História do Processamento de Linguagem Natural!
Referências
- [1] Jurafsky, D.; Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. 3rd ed. Online manuscript released August 19, 2026. URL